
Un file WAV registrato in studio viene convertito in MP3, caricato su una piattaforma, magari ripreso dal telefono durante un concerto. È ancora possibile dire con certezza che si tratta proprio di quella registrazione? Sì, grazie all'audio fingerprinting, l'impronta digitale del suono: la stessa tecnologia su cui si basano Shazam e i sistemi di riconoscimento delle grandi piattaforme video.
Perché i metadati non bastano
Un file WAV può contenere qualche informazione descrittiva: molti programmi di registrazione (DAW) scrivono blocchi come bext (formato Broadcast Wave), iXML o LIST/INFO, con il nome della sessione, la data o il software usato. Vale la pena controllarli con strumenti come ffprobe (parte di FFmpeg) o mediainfo.
Questi dati però sono fragili: basta una conversione in MP3 o un passaggio su un social network perché spariscano. Serve qualcosa che stia dentro il suono, non accanto.
Come funziona un'impronta acustica
Un sistema di fingerprinting non confronta i byte del file, ma il contenuto sonoro. Il segnale viene trasformato in uno spettrogramma (frequenze nel tempo) e da questo si estraggono i punti più caratteristici, come i picchi di energia più evidenti. Le relazioni tra questi punti, cioè quale frequenza segue quale e dopo quanto tempo, vengono codificate in brevi hash che formano l'impronta.
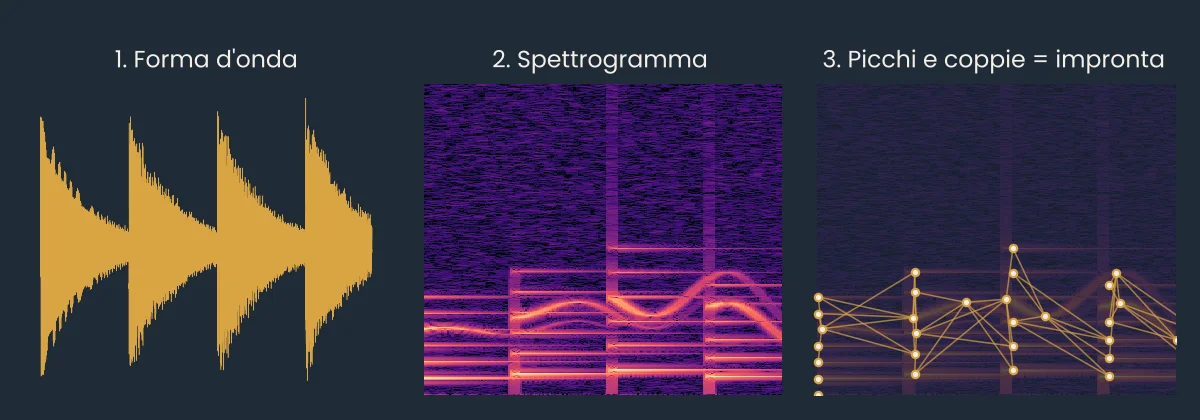
Il risultato ha proprietà molto utili:
- resiste alla ricodifica: MP3, AAC, OGG, cambi di volume o di frequenza di campionamento lasciano intatti i picchi principali;
- funziona su frammenti: pochi secondi bastano per trovare la corrispondenza e anche il punto esatto del brano;
- riconosce la singola registrazione, non la canzone: un'altra esecuzione dello stesso pezzo, anche dello stesso gruppo, produce un'impronta diversa. Il sistema identifica proprio quella take.
Strumenti liberi per provarci
Chromaprint / fpcalc (AcoustID)
È il cuore del progetto AcoustID, usato anche da MusicBrainz Picard per riconoscere i brani. Lo strumento a riga di comando fpcalc calcola l'impronta di un file intero ed è adatto a confrontare due file completi, ad esempio l'originale WAV con un MP3 trovato in rete. Il codice è sotto licenza MIT, con alcune parti di FFmpeg in LGPL 2.1.
Su Debian e Ubuntu si trova nel pacchetto libchromaprint-tools; per Windows, macOS e Linux ci sono anche i binari precompilati nella pagina delle release.
audfprint
audfprint di Dan Ellis (Columbia University) è scritto in Python, licenza MIT, e lavora a "punti di riferimento" (landmark). Si crea un piccolo database con le registrazioni originali e poi lo si interroga con qualsiasi file sospetto, anche un breve estratto registrato con il telefono. La risposta indica a quale originale corrisponde l'estratto, in che punto del brano e con quanti hash coerenti. Si installa dal repository GitHub con le dipendenze Python indicate nel file requirements.txt e richiede FFmpeg per leggere i diversi formati.
Panako
Panako di Joren Six è un sistema in Java pensato per archivi di grandi dimensioni, licenza AGPL 3.0. Include anche Olaf, un'implementazione dell'algoritmo descritto nell'articolo da cui è nato Shazam. Si installa compilandolo con Gradle oppure tramite Docker, e oltre a confrontare file può monitorare uno stream, ad esempio una diretta radio.
Il passo successivo: il watermarking
Il fingerprinting riconosce un audio già esistente. Il watermarking invece inserisce di proposito nell'audio un codice inaudibile prima di distribuirlo: piccole variazioni del segnale, distribuite nello spettro, che l'orecchio non percepisce ma un software sa leggere.
Nel mondo musicale professionale
Nelle produzioni indipendenti il watermarking è raro, ma nell'industria discografica e radiotelevisiva è una pratica consolidata:
- copie promozionali: prima dell'uscita di un disco, le etichette inviano a giornalisti, radio e DJ copie marcate con un codice diverso per ciascun destinatario. Se il brano compare in rete in anticipo, si risale a chi l'ha fatto trapelare;
- misurazione degli ascolti: molte emittenti radiofoniche e televisive inseriscono nel segnale trasmesso codici inaudibili che i misuratori degli istituti di rilevazione, come Nielsen, captano per stabilire che cosa viene ascoltato e quando;
- distribuzione digitale: alcuni servizi marcano i file venduti o scaricati, collegando ogni copia all'acquisto da cui proviene;
- contenuti generati dall'intelligenza artificiale: i principali sistemi di generazione audio iniziano a marcare i propri prodotti, per distinguerli dalle registrazioni reali.
La versione libera: audiowmark
Con audiowmark di Stefan Westerfeld (licenza GPL 3) si può nascondere un messaggio di 128 bit nello spettro del segnale. Il messaggio sopravvive alla conversione in MP3 di buona qualità e si legge senza bisogno del file originale.
Usando una chiave privata, solo chi la possiede può leggere o rimuovere il codice. Assegnando un codice diverso a ogni copia consegnata, ad esempio una per ciascun artista o destinatario, si può risalire anche a quale copia è stata diffusa: la stessa logica delle copie promozionali delle etichette, alla portata di una piccola associazione. audiowmark è disponibile come pacchetto in Debian e openSUSE, oppure si compila dai sorgenti.
In pratica
- Conservate sempre l'originale (WAV o, meglio, le tracce multitraccia della sessione): è il riferimento per ogni confronto e la prova più solida dell'origine.
- Per verificare un file già in circolazione usate il fingerprinting (Chromaprint, audfprint, Panako).
- Per le registrazioni future, valutate di applicare un watermark prima della consegna.
Questi strumenti dicono se due audio coincidono, non chi ne detiene i diritti: per quello contano gli accordi presi al momento della registrazione.