Un'ora di diretta radiofonica, tre ospiti, tante chiacchiere e altrettanta musica. Volevamo conservare e condividere le parole dell'intervista, con i sottotitoli, lasciando da parte le canzoni: sia per rendere il materiale più agile, sia per rispetto del diritto d'autore sui brani trasmessi. Farlo a mano significa ore di ascolto, taglio e trascrizione. Abbiamo provato ad automatizzare quasi tutto con strumenti liberi e gratuiti, prima su un computer portatile tutt'altro che recente, poi su un PC con una scheda grafica di qualche generazione fa. Ecco com'è andata.
Il punto di partenza
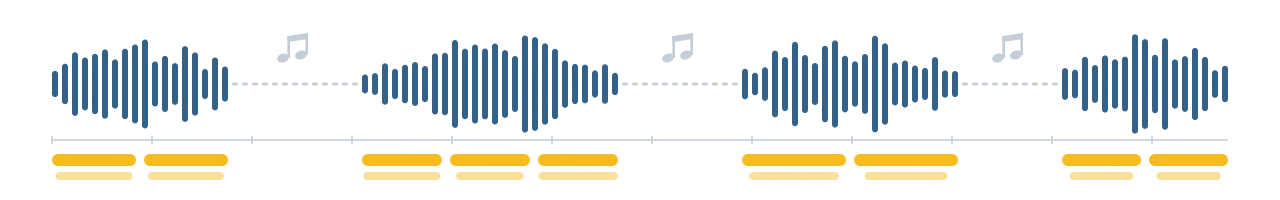
Il materiale era la registrazione di una puntata di A Touch of Music su Radio Studio 91 Live: 61 minuti in cui l'intervista si alterna a canzoni, sigle e jingle. L'obiettivo:
- riconoscere automaticamente dove si parla e dove c'è musica;
- ottenere due versioni audio: una con solo il parlato (musica tagliata) e una di durata originale con la musica silenziata;
- generare i sottotitoli in formato SRT, da rivedere e correggere;
- trasformare l'audio sottotitolato in un video da condividere sul web e sui social.
Un primo tentativo, basato su un rilevatore di musica pensato per altri scopi e su qualche regola "a soglia", non aveva dato risultati soddisfacenti: parlato e musica si confondevano troppo spesso. Siamo quindi ripartiti scegliendo strumenti nati per questo tipo di lavoro.
Gli strumenti che abbiamo scelto, e perché
inaSpeechSegmenter: chi parla e chi canta
inaSpeechSegmenter è sviluppato dall'INA, l'istituto francese che conserva gli archivi della radio e della televisione pubblica. È stato addestrato proprio su trasmissioni radio-TV e distingue parlato, musica, rumore e silenzio. È la scelta naturale per una registrazione radiofonica: riconosce come parlato anche la voce del conduttore sopra un sottofondo musicale, e considera musica il cantato.
Sulla nostra puntata ha classificato 31 minuti di parlato e 29 di musica in pochi minuti di calcolo, con confini tra intervista e canzoni sostanzialmente corretti. Qualche regola di pulizia aggiuntiva accorpa i frammenti troppo brevi (un colpo di batteria in mezzo a una frase, una parola cantata in mezzo a un brano).
Whisper (faster-whisper): dalle parole ai sottotitoli
Per la trascrizione abbiamo usato faster-whisper, una reimplementazione ottimizzata del modello di riconoscimento vocale Whisper di OpenAI. Rispetto alla versione originale è molto più rapido e occupa meno memoria, a parità di qualità, sia sul processore sia sulla scheda grafica. Trascriviamo solo il parlato: si risparmia metà del tempo e si evita che Whisper provi a "trascrivere" i testi delle canzoni.
Sul portatile abbiamo confrontato tre modelli sullo stesso minuto di intervista:
| Modello | Tempo per 1 minuto di audio | Qualità |
|---|---|---|
small |
32 secondi | nomi propri storpiati, frasi imprecise |
medium |
86 secondi | buona, ma poca punteggiatura |
large-v3-turbo |
82 secondi | la migliore: nomi, punteggiatura e frasi corretti |
Il modello large-v3-turbo è veloce quanto medium ma scrive decisamente meglio, ed è diventato la scelta predefinita. Per aiutarlo con i nomi degli ospiti gli si può suggerire un breve testo iniziale con i nomi scritti correttamente.
ffmpeg e Python: il montaggio
ffmpeg è il "coltellino svizzero" dell'audio e del video: decodifica la registrazione e codifica i file finali. Il montaggio vero e proprio lo fa un piccolo programma in Python, che in un'unica passata produce sia la versione tagliata sia quella silenziata, con brevi dissolvenze a ogni taglio per evitare click e salti bruschi. Abbiamo verificato che nei tratti musicali la versione silenziata sia davvero muta: il livello misurato è di −91 dB, cioè silenzio digitale.
I sottotitoli vengono generati sulla versione tagliata e poi "riportati" sui tempi della registrazione originale, così ciascuna versione audio ha il suo file SRT sincronizzato.
uv: installazione senza complicazioni
Gli strumenti sono raccolti nel pacchetto libero casoweb-tools: il README spiega come installarli con uv, anche nella variante leggera per i PC senza scheda NVIDIA. Le opzioni dei singoli comandi sono descritte nella documentazione. Una volta installato, la separazione del parlato si lancia così:
casoweb separa-parlato registrazione.webmUn dettaglio che ha fatto la differenza sul portatile: la libreria di segmentazione, di serie, si porta dietro diversi gigabyte di componenti per le schede grafiche NVIDIA, inutili su una macchina che non ne ha una. Nella variante leggera li abbiamo esclusi, e l'ambiente completo è passato da oltre 7 GB a circa 2 GB.
Un flusso di lavoro "umano nel mezzo"
L'automazione non sostituisce la revisione, la rende più rapida. Per questo lo script salva:
- la segmentazione parlato/musica in una semplice tabella (un file di testo apribile anche con un foglio di calcolo), che si può correggere a mano: basta cambiare "parlato" in "musica" su una riga e rilanciare;
- la trascrizione grezza, con i tempi della registrazione originale: dopo una correzione i sottotitoli si rigenerano in pochi secondi, e Whisper lavora solo sui tratti eventualmente diventati "parlato".
Nella nostra puntata la revisione si è ridotta a pochi punti: un breve verso cantato scambiato per parlato, un jingle della radio da tenere o togliere, qualche nome proprio da ricontrollare. Il risultato finale conta circa 650 sottotitoli, leggibili (al massimo due righe, pochi secondi ciascuno) e senza le classiche frasi "inventate" che Whisper talvolta aggiunge nei silenzi.
Prima prova: un portatile del 2015
Il primo giro è stato svolto su un portatile con processore Intel Core i5-5200U (due core, uscito nel 2015), 16 GB di memoria e nessuna scheda grafica dedicata. I tempi:
- segmentazione parlato/musica dell'intera ora: meno di 3 minuti;
- produzione delle due versioni audio: pochi minuti;
- trascrizione dei 31 minuti di parlato con il modello migliore: circa 40 minuti.
Meno di un'ora di calcolo, lasciato girare da solo mentre si faceva altro, per un lavoro che a mano avrebbe richiesto un pomeriggio intero. Non serve quindi hardware costoso per iniziare: un computer datato, strumenti liberi e un po' di pazienza bastano.
Attenzione ai computer davvero vecchi. La segmentazione parlato/musica richiede un processore con le istruzioni AVX (all'incirca dal 2011 in poi). Su uno più datato casoweb se ne accorge e lo dice, invece di fermarsi con un errore criptico; si può comunque segmentare su un altro PC e trascrivere sul computer vecchio.
Il comando per controllare il proprio processore è nel README, i dettagli sono nella documentazione.
Seconda prova: una GTX 1060 usata
La trascrizione era la fase più lenta, ed è proprio quella che trae più vantaggio da una scheda grafica. Abbiamo quindi ripetuto l'elaborazione su un PC desktop con Ubuntu e una NVIDIA GeForce GTX 1060 da 6 GB: una scheda di qualche generazione fa, reperibile usata a meno di 100 euro, ma sufficiente per i modelli Whisper più grandi.
Lo script usa la GPU se la trova e, in caso di problemi con la scheda, torna automaticamente al processore. Le librerie NVIDIA necessarie arrivano già con l'installazione, quindi basta lo stesso comando, con in più, volendo, i nomi degli ospiti:
casoweb separa-parlato registrazione.webm --nomi "Nome Ospite1, Nome Ospite2"La GTX 1060 non gestisce bene i calcoli a 16 bit (float16) che le schede più recenti usano per accelerare Whisper; lo script se ne accorge e sceglie da solo una modalità a 8 bit (int8), che sta comoda nei 6 GB di memoria della scheda.
Il confronto con il portatile:
| Fase | Portatile (solo processore) | PC con GTX 1060 |
|---|---|---|
| Segmentazione parlato/musica (61 minuti) | meno di 3 minuti | circa 4 minuti |
Trascrizione dei 31 minuti di parlato (large-v3-turbo) |
circa 40 minuti | meno di 2 minuti |
La trascrizione è diventata oltre 20 volte più veloce, con una qualità molto buona: restano solo piccoli errori da sistemare a mano. La segmentazione, invece, gira sul processore in entrambi i casi, e i tempi dipendono soprattutto da quello. Il risultato della segmentazione è stato in pratica identico: 31,1 minuti di parlato e 29,8 di musica.
Due note pratiche per chi ci prova:
- al primo avvio Whisper scarica il modello da Hugging Face (circa 1,6 GB), che poi resta in cache. Nel nostro caso il download si era bloccato: lo abbiamo sbloccato scaricando il modello a parte con il trasferimento "classico", cioè anteponendo
HF_HUB_DISABLE_XET=1al comandouvx --from huggingface_hub hf download mobiuslabsgmbh/faster-whisper-large-v3-turbo; - l'avviso su
HF_TOKENche compare durante il download si può ignorare: il token serve solo per limiti più alti o per modelli riservati, e quelli usati qui sono pubblici.
Dall'audio al video sottotitolato
Un file MP3 con un SRT accanto non è comodo da condividere: i normali lettori audio non mostrano i sottotitoli (sul computer si può usare mpv, che carica da solo l'SRT con lo stesso nome dell'audio). Per pubblicare l'intervista abbiamo quindi aggiunto un secondo comando, casoweb video-da-audio, che parte dall'audio già pronto e lo trasforma in un video con un'immagine fissa di sfondo (per esempio la locandina della puntata, o uno sfondo nero se non se ne indica una) e i sottotitoli sovrapposti. Non richiede Whisper né GPU: bastano ffmpeg e Python.
casoweb video-da-audio intervista_parlato.mp3 --immagine locandina.jpgLo script:
- produce in una volta sola più versioni, adatte a piattaforme diverse: YouTube (1080p), web (720p), WhatsApp, e su richiesta anche quadrato e verticale per gli estratti sui social;
- adatta l'immagine alle proporzioni del video, mostrandola intera con bande colorate oppure ritagliandola per riempire lo schermo;
- aggiunge mezzo secondo di "respiro" con dissolvenza all'inizio e alla fine, spostando di conseguenza i sottotitoli;
- incide i sottotitoli nell'immagine oppure, a scelta, li inserisce come traccia attivabile dal lettore;
- salva i parametri usati, per riprodurre lo stesso risultato sulle puntate successive.
La versione per WhatsApp ha richiesto qualche ritocco. La prima prova superava i 60 MB per mezz'ora di intervista, decisamente troppo. Il colpevole era la frequenza dei fotogrammi chiave, le immagini complete che il video ripete a intervalli regolari: uno ogni due secondi. In un video con l'immagine ferma sono proprio loro a pesare di più, insieme all'audio. Con un fotogramma chiave ogni 30 secondi, 5 fotogrammi al secondo, risoluzione 960×540 e audio mono a 32 kb/s (più che sufficiente per la voce) si rientra nell'ordine di grandezza dei 10-15 MB per mezz'ora, con una qualità più che accettabile. Lo script avvisa comunque se il file supera i 16 MB.
In conclusione
Con strumenti liberi e gratuiti si ottiene un risultato molto buono già su un portatile di dieci anni fa, lasciandolo lavorare un'oretta. Una scheda grafica usata da meno di 100 euro riduce la trascrizione da decine di minuti a un paio, e rende comodo ripetere il lavoro a ogni puntata. Il tempo risparmiato si sposta dove serve davvero: la revisione umana dei sottotitoli.
E c'è già un'idea per il futuro: sovrapporre al video un orologio con l'ora esatta della diretta, ricavata confrontando la registrazione con un secondo salvataggio dello streaming. Ma questa è un'altra storia.
Se ti incuriosisce da dove nasce inaSpeechSegmenter e perché è stato creato, leggi inaSpeechSegmenter: dal monitoraggio della parità di genere agli strumenti liberi per l’audio.
Il lavoro è stato svolto con l'aiuto di Claude, l'assistente di Anthropic, che ha contribuito alla scelta degli strumenti, alla scrittura degli script e alle verifiche sui risultati.